Modelos de lenguaje en la nube: cómo se integran
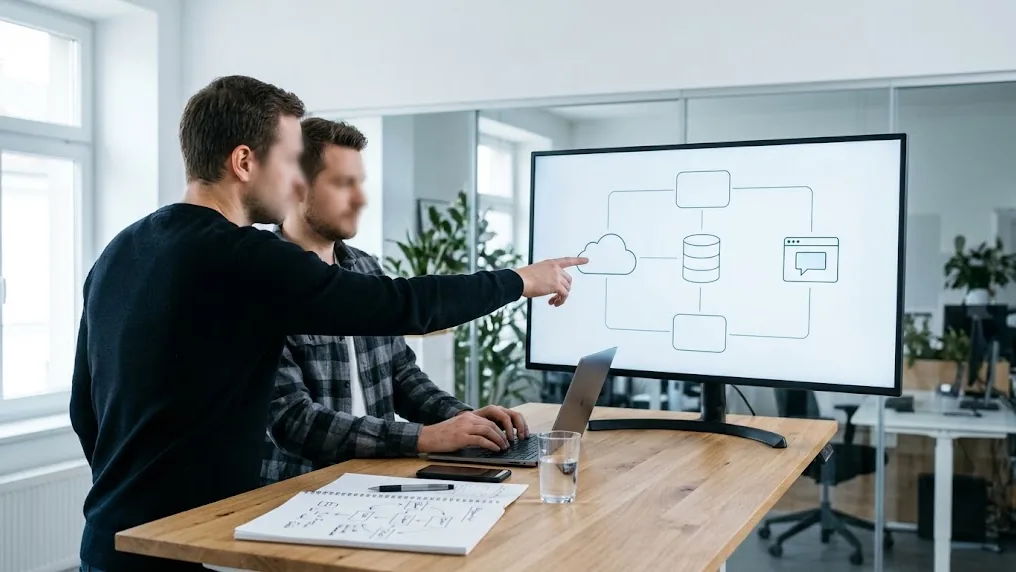
Los modelos de lenguaje en la nube rinden cuando se conectan con los datos y los sistemas que la empresa ya tiene. Un modelo aislado responde con lo que aprendió durante su entrenamiento, y eso no alcanza para contestar preguntas sobre la información propia de una organización.
Esta guía repasa qué hay que resolver para integrarlos y qué casos de la región documentó Google Cloud. Como lectura aparte, existe un texto de Medium sobre las empresas latinoamericanas en la nube, titulado «Principales empresas latinoamericanas que implementan soluciones en la nube».
¿Qué implica integrar modelos de lenguaje en la nube?
Implica darle al modelo acceso a información que no tiene. La documentación de Google Cloud lo plantea así: un problema habitual de los LLM es que no conocen los datos privados de la organización, y con RAG Engine se puede enriquecer el contexto del modelo con esa información para reducir las alucinaciones y responder con más precisión.
El proceso tiene seis pasos: ingesta de datos, transformación, embeddings, indexado, recuperación y generación. Los documentos se dividen en fragmentos y se convierten en vectores numéricos. Cuando alguien pregunta, el sistema busca los fragmentos más cercanos y se los entrega al modelo junto con la pregunta.
La documentación de Amazon Bedrock suma un argumento económico: una base de conocimiento evita reentrenar el modelo de forma continua para que use datos privados.
¿Cómo se conecta con los sistemas que ya existen?
Con una capa intermedia, un agente, que recibe la pregunta y consulta el sistema. Según Google Cloud, la empresa brasileña de energía Copel desarrolló un agente que funciona con Gemini Pro 1.5 e interactúa con su sistema SAP ERP on-premises, de modo que los funcionarios hacen preguntas en lenguaje natural. El ERP sigue en las instalaciones de la empresa.
El banco brasileño Banco BV usa Google Agentspace para que sus empleados apliquen IA generativa en la búsqueda, la asistencia y las acciones sobre sus sistemas críticos, de manera segura y conforme a las reglas, según la misma publicación.
La IA también puede quedar detrás de un canal de mensajería. Banco Rendimiento usa Vertex AI y otras soluciones para un servicio de transferencias internacionales por WhatsApp que funciona las 24 horas, sin que el cliente hable con un especialista para completar la operación.
¿Qué se puede hacer con los datos propios?
Consultarlos en lenguaje natural. La manufacturera Suzano aplica IA generativa para que casi 50.000 funcionarios accedan casi al instante a la información de sus fuentes. NotCo, de tecnología alimentaria en Chile, desarrolló un chatbot con Gemini para que sus colaboradores obtengan información en tiempo real y tomen mejores decisiones.
Quien ya trabaja con BigQuery puede llamar al modelo desde SQL. La función AI.GENERATE_TEXT usa un modelo remoto sobre Gemini, Claude, Llama o Mistral y genera texto a partir de tablas estándar o de datos no estructurados.
¿Qué pasa con la privacidad de la información?
Depende del proveedor y de su documentación. Microsoft indica que los prompts, las respuestas, los embeddings y los datos de entrenamiento de sus modelos en Foundry no están disponibles para otros clientes ni para OpenAI, y que no se usan para entrenar modelos base sin permiso del cliente.
AWS explica que, en Amazon Bedrock, los proveedores de modelos no tienen acceso a las cuentas donde se despliegan sus modelos, ni a los registros, los prompts o las respuestas de los clientes.
Microsoft agrega que sus modelos no guardan estado: ningún prompt ni respuesta queda almacenado en el modelo, y el procesamiento ocurre dentro de la geografía que elige el cliente, salvo en los despliegues de tipo Global o DataZone.
Las condiciones cambian con el tiempo y con cada contrato, así que se leen en la documentación vigente antes de elegir.
¿Cómo empezar sin apostar todo?
Con un proceso acotado: una pregunta frecuente de un área, un conjunto de documentos y una persona que valide las respuestas. Si el modelo contesta bien, se suman fuentes y usuarios de a poco.
Conviene medir en cada paso si las respuestas siguen siendo correctas, porque un modelo conectado a más datos también puede equivocarse con más información. Los casos de Copel, Banco BV, Suzano y NotCo comparten un punto de partida claro: el modelo trabaja sobre sistemas y datos que la empresa ya tenía.